Prometheus 호환 대규모 TSDB 4대장(Thanos, Cortex, VictoriaMetrics, Mimir) 비교 및 Mimir 내부 원리 정리.
4대장 비교
제품 핵심 정의 최대 장점 최대 단점
| VictoriaMetrics | 쓰기/저장/읽기 3개 컴포넌트의 초단순 아키텍처 | 압도적 관리 편의성, 높은 성능 | Block Storage 종속 → 장기 보관 비용·확장성 저하. Hash ring 없어 rebalancing 수동 |
| Thanos | 기존 Prometheus 위에 Sidecar를 얹는 확장형 | 기존 Prometheus 환경 재사용 가능 | 신규 구축 시 아키텍처 기형. 실시간 분산 집계 병목 |
| Grafana Mimir | 처음부터 대규모를 타깃한 Object Storage 네이티브 분산 클러스터 | 무한 확장성, Query Frontend 조회 속도, 철저한 멀티테넌시 | 마이크로서비스 컴포넌트 多 → 운영 복잡도 높음 |
| Cortex | Mimir의 모태인 1세대 분산 TSDB | 검증된 아키텍처 | Grafana Labs의 Mimir 집중으로 사실상 deprecated |
Mimir를 선택한 이유:
- Cortex co-author + 주요 contributor가 Grafana 소속 → Cortex 기여 87%가 Grafana
- Prometheus 확장에서 진화한 Thanos와 달리 처음부터 대규모 설계
- Grafana(metric consumer 압도적 1위)와의 유착 관계
- Loki, Tempo와 아키텍처·컴포넌트 이름을 공유 → 운영 지식 재사용
- PromQL 100% 호환 (VictoriaMetrics는 74%)
전체 파이프라인 구조
쓰기
[Prometheus scrape / OTEL Collector]
          │ remote_write
          ▼
    ┌─── Distributor ───┐     ← stateless. 유효성 검사 + 복제 분산
    │    Hash Ring 조회  │
    └───────────────────┘
       │           │         │
       ▼           ▼         ▼
  Ingester-1  Ingester-2  Ingester-3   ← stateful (RF=3, Quorum=2)
  WAL + Mem   WAL + Mem   WAL + Mem
       │
  2h flush
       ▼
  Object Storage (S3 / GCS)
       │
  Compactor ─── 수직 압축(dedup) → 수평 압축(merge)
       │
  Store Gateway ─── index 캐시, bucket view 유지
읽기
[Grafana PromQL]
       ▼
 Query Frontend  ── ① Results Cache (memcached) 확인
       │             ② 캐시 미스 → FIFO Queue
       ▼
 Query Scheduler (optional) ── 큐 부하 분산
       ▼
    Querier  ── 최근: Ingester 직접 / 장기: Store Gateway → S3
       │
 결과 반환 → Query Frontend 병합 → Grafana
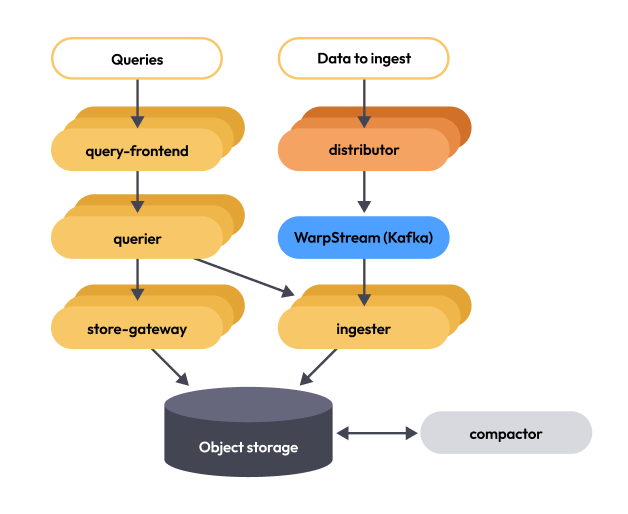
Write Path 상세
Distributor — 분산 + 복제
Hash Ring 동작:
- Tenant ID + Metric Name + Labels 조합을 해시 → 토큰 생성
- Memberlist(Gossip 프로토콜) 기반 Hash ring 조회 → 담당 Ingester 3대 선택
- 3대에 동시 전송 → 과반수(2대) 응답 시 클라이언트에 성공 반환 (Mimir의 고가용성)
Quorum 일관성: RF=3, Quorum=2 (N/2+1). Ingester 1대 죽어도 읽기/쓰기 모두 정상.
Ingester — 이중 기록과 플러시
수신 샘플
    ├── in-memory Head Block (빠른 읽기용)
    └── WAL on EBS (장애 복구용)

2시간마다:
    Head Block → 압축 → Chunk 블록 파일
    → S3 업로드 완료 후 WAL truncate
StatefulSet 배포 이유 2가지:
- WAL을 EBS 같은 영구 디스크에 유지해야 함
- Pod 고유 네트워크 Identity 유지 → Querier가 2시간 이내 최신 데이터를 끊김 없이 읽어갈 수 있어야 함
→ 책 이론의 "Kafka 유실 방지 버퍼" = Mimir에서는 Ingester의 WAL이 동일 역할 수행
Read Path 상세
Query Frontend — Spiky Read 제어
책 5장의 "High Write / Spiky Read" 요구사항을 query-frontend가 해결한다.
① 쿼리 슈레딩 (Query Splitting):
"지난 30일 P99 레이턴시" 요청
    ↓ query-frontend가 1일 단위 30개 서브쿼리로 분할
    ↓ 30개 병렬 실행
    ↓ S3 블록도 일 단위로 분할되어 있음 → 30 Querier가 각자 다른 파일 블록 읽기
    ↓ Share-Nothing: 병목 전무
② Results Cache:
- memcached 기반 (results-cache, chunks-cache, index-cache 3종)
- 캐시 히트 시 TSDB 조회 없이 즉시 반환
- 책의 "Redis 캐시" 역할
③ FIFO Queue + Query Scheduler:
출근 시간 수백 명 동시 대시보드 로딩 (Spiky Read)
    ↓
FIFO Queue에 적재 (TSDB로 바로 던지지 않음)
    ↓
Querier가 CPU/메모리 여유 있을 때만 Pull
    ↓
OOM 방지, 시스템 안정성 유지
Query Scheduler 없으면: query-frontend 수평 확장 시 큐가 인스턴스마다 분산 → 불균형. Scheduler가 큐를 단일 관리.
Querier — 데이터 소스 2원화
데이터 출처
| 최근 2시간 이내 | Ingester 직접 조회 (in-memory) |
| 2시간 이상 장기 | Store Gateway → S3 블록 조회 |
Store Gateway는 stateful — bucket index를 로컬 디스크에 캐싱, 주기적으로 S3와 동기화.
Compactor 상세
→ 책 이론의 "저장소 계층 최적화"를 두 단계로 구현
수직 압축 (Vertical Compaction) — 중복 제거
동일 시간대(2h) 블록이 Ingester RF=3 때문에 3개 존재
→ 타임스탬프+값 완전 일치 샘플 2개 제거
→ 스토리지 1/3으로 압축
수평 압축 (Horizontal Compaction) — 블록 병합
2h 블록 여러 개 → 12h 블록 → 24h 블록
인접 시간 블록 병합 → 인덱스 크기 감소 → 쿼리 스캔 범위 축소
Split-and-Merge — 64GiB 한계 돌파
Prometheus 기본 규격: 인덱스 파일 최대 64GiB 제한.
장기 블록(24h 이상)은 이 한계를 초과할 수 있음.
Mimir 해결책:
블록 병합 시 series.hash() mod 32 → 32개 샤드 블록으로 분할 출력
각 샤드는 64GiB 이하 유지
→ 인덱스 크기 제한 없이 무한 수평 확장 가능
Multi-tenancy
HTTP Header: X-Scope-OrgId: tenant-id

각 Ingester가 테넌트별 독립 TSDB 유지
Compactor도 테넌트별 독립 압축
Grafana datasource에 custom header 설정으로 테넌트 격리
실용 활용: dev / stage / prod를 tenant로 분리 → 단일 Mimir 클러스터로 3개 환경 운용 가능.
Loki, Tempo와의 공통 아키텍처
Grafana에서 만든 3개 백엔드가 동일한 컴포넌트 구조를 공유한다.
컴포넌트 Mimir (Metrics) Loki (Logs) Tempo (Traces)
| 수신 | Distributor | Distributor | Distributor |
| 저장 | Ingester | Ingester | Ingester |
| 압축 | Compactor | Compactor | Compactor |
| 조회 | Querier | Querier | Querier |
| 쿼리 최적화 | Query Frontend | Query Frontend | Query Frontend |
| 장기 저장 | S3 | S3 | S3 |
→ Mimir 운영 지식이 Loki, Tempo에 그대로 전이됨. Loki 데이터 모델도 Prometheus와 동일 (value만 float → string).
책 이론 → Mimir 구현 매핑 요약
책 5장 이론 Mimir 구현체
| 지표 수집기 | Distributor |
| Kafka 유실 방지 버퍼 | Ingester WAL (EBS) |
| 수집기 해시 링 샤딩 | Memberlist 기반 Hash ring + Quorum |
| TSDB | Ingester(최근) + Store Gateway + S3(장기) |
| 질의 서비스 | Querier |
| Redis 캐시 | memcached (results/chunks/index 3종) |
| 스파이크 읽기 제어 | Query Frontend FIFO Queue + Query Scheduler |
| 데이터 압축 | Compactor 수직 압축 (dedup) |
| 다운샘플링 | Compactor 수평 압축 + Split-and-Merge |
해당 글을 작성하기 위해 참고한 글 입니다.
https://joeunvit.tistory.com/19
Grafana mimir overview
Grafana mimir에 대한 전반적인 자료 수집 내용을 정리해봤습니다. Grafana Labs에서 Cortex 개발을 주도하고 있었지만, Mimir를 출시하면서 Cortex는 더 이상 개발하지 않습니다. https://grafana.com/blog/2020/01/16/
joeunvit.tistory.com
https://www.anyflow.net/sw-engineer/prometheus-large-scale-comparison
Prometheus: 대용량 처리 제품 비교
대용량 메트릭 운용을 위한 Prometheus 호환 제품 비교로 Thanos, Cortex, VictoriaMetrics, Mimir를 중심으로 다룬다. Prometheus는 대용량 처리를 위해 Federation 아키텍처를 제안하나 여러모로 제한이 있기에, 대
www.anyflow.net
'Computer Science > CS' 카테고리의 다른 글
| Git Branch 종류 (1) | 2024.11.26 |
|---|---|
| Http와 Https (1) | 2024.09.27 |
| Redis (0) | 2024.01.18 |
| 원자성,가시성 (0) | 2023.02.02 |
| 동기화 , 비동기화 (0) | 2023.01.21 |