Network
Prometheus 디스코드 웹훅
Ry-
2025. 10. 2. 07:50
백엔드 서버가 가동중일시 이 서버를 모니터링할 수 있는 Prometheus라는 오픈소스가 있다.
Prometheus는 서버의 Metrics 정보를 수집하는 서버로서 Grafana와 같이 연동하여 모든 데이터를 시각화한다.
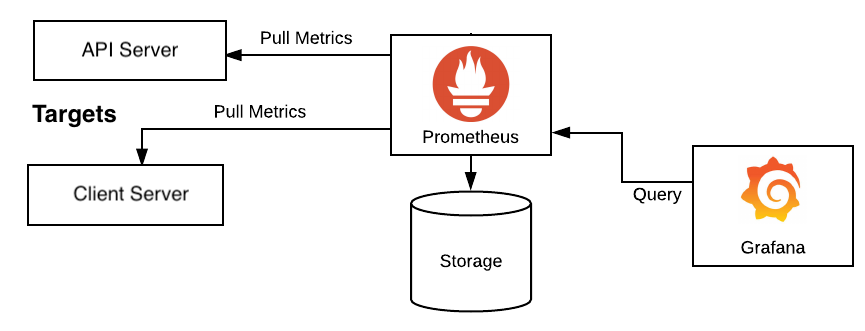
오늘은 Node.js 백엔드에 Prometheus을 적용하여 백엔드 서버가 다운될 때 알림을 디스코드 WebWook을 통해서 알리도록 하겠습니다.
Prometheus나 Grafana는 웹사이트에서도 다운로드할 수 있지만, 저는 Docker을 이용해 이미지를 가져와 컨테이너로 만들었습니다.
│  docker-compose.yml
│
├─alertmanager
│      alertmanager.yml
│
├─backend
│      .gitignore
│      Dockerfile
│      package.json
│      server.js
│
└─prometheus
        prometheus.yml
        rules.yml
#Dockerfile
FROM node:16-alpine
WORKDIR /app
COPY package*.json ./
RUN npm install
COPY . .
EXPOSE 8080
CMD ["node", "server.js"]
#package.json
{
  "name": "discord-webhook-proxy",
  "version": "1.0.0",
  "main": "server.js",
  "dependencies": {
    "express": "^4.18.2",
    "axios": "^1.5.0"
  }
}
#app.js
app.post('/webhook', async (req, res) => {
  console.log('Received alert:', JSON.stringify(req.body, null, 2));
  const { alerts } = req.body;
백엔드에서는 post 메서드로 서버의 상태를 출력하고 있으면 된다
docker-compose.yml
version: '3.8'

services:
  backend:
    build: ./backend
    container_name: backend-app
    ports:
      - "3000:3000"
    networks:
      - monitoring

  prometheus:
    image: prom/prometheus:latest
    container_name: prometheus
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml
      - ./prometheus/rules.yml:/etc/prometheus/rules.yml
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.path=/prometheus'
    ports:
      - "9090:9090"
    networks:
      - monitoring
    depends_on:
      - backend

  alertmanager:
    image: prom/alertmanager:latest
    container_name: alertmanager
    volumes:
      - ./alertmanager/alertmanager.yml:/etc/alertmanager/alertmanager.yml
    command:
      - '--config.file=/etc/alertmanager/alertmanager.yml'
    ports:
      - "9093:9093"
    networks:
      - monitoring

  grafana:
    image: grafana/grafana:latest
    container_name: grafana
    ports:
      - "3001:3000"
    environment:
      - GF_SECURITY_ADMIN_PASSWORD=admin
    networks:
      - monitoring

networks:
  monitoring:
    driver: bridge
prometueus.yml
global:
  scrape_interval: 15s
  evaluation_interval: 15s

# Alertmanager 설정
alerting:
  alertmanagers:
    - static_configs:
        - targets:
            - alertmanager:9093

# 규칙 파일 로드
rule_files:
  - "rules.yml"

# 스크레이프 대상 설정
scrape_configs:
  - job_name: 'backend'
    static_configs:
      - targets: ['localhost:3000']
    metrics_path: '/metrics'

  - job_name: 'prometheus'
    static_configs:
      - targets: ['localhost:9090']
이때 alertmanager의 규칙을 정할 수 있는 rule이 중요하다.
groups:
  - name: backend_alerts
    interval: 30s
    rules:
      # 서비스 다운
      - alert: ServiceDown
        expr: up{job="backend"} == 0
        for: 15s
        labels:
          severity: critical
        annotations:
          summary: "🔴 Backend service is down"
          description: "Backend service has been down for more than 1 minute"
summary, description을 통해서 실제 디스코드에서 나올 오류 메시지를 정할 수 있다.
global:
  resolve_timeout: 5m

route:
  group_by: ['alertname', 'cluster', 'service']
  group_wait: 10s
  group_interval: 10s
  repeat_interval: 1h
  receiver: 'backend_alerts'
  routes:
    - match:
        severity: critical
      receiver: 'backend_alerts'
      repeat_interval: 5m

receivers:
  - name: 'discord_webwook'
    discord_configs:
      - webhook_url: '(url) 입력'
        title: '{{ .CommonAnnotations.summary }}'
        message: '{{ .CommonAnnotations.description }}'
        send_resolved: true
rule에 적은 대로 서버에 어떤 문제가 발생하게 되면 alertmanager에 들어와서 match에 맞는 작업들을 수행하게 됩니다.
이제 docker을 실행해 주고 백엔드 서버를 끄게 되면

이처럼 discord에 백엔드 서버가 꺼졌다고 알림이 오게 됩니다.
#도커 명령어
docker-compose up -d # 도커 컴포즈 파일 실행 -d 는 demon으로 실행 터미널 유지할 필요 X
docker logs [id or name] # 서버 오류 확인
docker ps -a # 꺼진 컨테이너 까지 다 확인
docker system prune -f # 컨테이너 정리